Datenmaskierung, synthetische Testdaten und Subsetting verbinden Datenschutz mit realistischen Tests!
Moderne Software muss schnell entwickelt, zuverlässig getestet und kontinuierlich verbessert werden. Dafür benötigen Entwicklungs- und Qualitätssicherungsteams realistische Testdaten. Die direkte Verwendung personenbezogener oder anderer sensibler Produktivdaten birgt jedoch erhebliche Datenschutz- und Sicherheitsrisiken. Ein professionelles Test Data Management schafft die notwendige Verbindung zwischen Datenqualität, Softwarequalität und Datenschutz.
Produktionsnahe Testdaten bilden reale Datenstrukturen, Formate und Beziehungen möglichst genau ab. Dadurch lassen sich Anwendungen unter realistischen Bedingungen prüfen, Fehler frühzeitig erkennen und neue Funktionen zuverlässig validieren. Gleichzeitig dürfen Test- und Entwicklungsumgebungen keine unnötigen Rückschlüsse auf Kunden, Beschäftigte, Patienten oder Geschäftspartner ermöglichen.
Wie lassen sich Produktivdaten sicher für Tests nutzen?
Eine zentrale Methode ist die Datenmaskierung. Dabei werden personenbezogene und vertrauliche Informationen gezielt verändert, ersetzt, verschlüsselt oder pseudonymisiert. Die ursprünglichen Werte sind anschließend nicht mehr erkennbar, während Struktur, Format und fachliche Verwendbarkeit der Daten erhalten bleiben.
Namen, Adressen, Kontodaten, Telefonnummern oder andere schützenswerte Informationen können so realistisch dargestellt werden, ohne die Originalwerte in weniger geschützte Testsysteme zu übernehmen. Die Maskierung unterstützt Unternehmen dabei, Datenschutzvorgaben wie die DSGVO auch in Softwareentwicklung, Qualitätssicherung und DevOps-Prozessen angemessen zu berücksichtigen.
Datenmaskierung oder synthetische Testdaten?
Datenmaskierung und synthetische Datengenerierung verfolgen unterschiedliche Ansätze. Bei der Maskierung dienen vorhandene Datenbestände als Grundlage. Sensible Inhalte werden verändert, während Datenstruktur und fachliche Zusammenhänge erhalten bleiben.
Synthetische Testdaten werden dagegen vollständig neu erzeugt. Sie basieren auf definierten Regeln, Formaten, Wertebereichen und Verteilungen und enthalten keine realen personenbezogenen Ausgangsdaten. Dabei können auch gezielt Sonderfälle, Grenzwerte, ungültige Eingaben oder seltene Konstellationen generiert werden.
Welche Methode besser geeignet ist, hängt vom jeweiligen Anwendungsfall ab. Häufig bietet eine Kombination aus maskierten Produktivdaten und synthetisch erzeugten Datensätzen die größte Flexibilität.
Relevante Datenbestände durch Subsetting verkleinern: Für viele Tests wird keine vollständige Kopie einer produktiven Datenbank benötigt. Database Subsetting reduziert große Datenbestände auf eine kleinere, fachlich relevante Teilmenge. Entscheidend ist dabei, dass Beziehungen zwischen Tabellen und Datensätzen erhalten bleiben.
Ein ausgewählter Kundendatensatz muss beispielsweise weiterhin mit den zugehörigen Adressen, Verträgen, Zahlungen und Vorgängen verbunden sein. Referenziell korrekte Teilmengen reduzieren Speicherbedarf und Bereitstellungszeiten, ohne die Aussagekraft der Tests zu beeinträchtigen.
Automatisierte Testdaten für CI/CD und DevOps: Manuelle Verfahren stoßen bei großen Datenmengen, komplexen Systemlandschaften und kurzen Entwicklungszyklen schnell an ihre Grenzen. Moderne Testdatenprozesse müssen deshalb automatisierbar, wiederholbar und skalierbar sein.
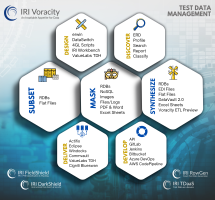
Datenprofiling, Klassifizierung, Maskierung, Transformation, Subsetting und synthetische Datengenerierung lassen sich in standardisierte Abläufe integrieren. Dadurch können benötigte Testdaten bedarfsgerecht bereitgestellt und regelmäßig aktualisiert werden. Die Einbindung in CI/CD-Pipelines unterstützt automatisierte Tests und beschleunigt die Entwicklung neuer Softwareversionen.
Integriertes Test Data Management mit IRI Voracity: IRI Voracity verbindet zentrale Funktionen für Datenmanagement, Datenschutz und Testdatenbereitstellung in einer einheitlichen Plattform. Sensible Daten können identifiziert, klassifiziert, transformiert und mit wiederverwendbaren Regeln geschützt werden.
Die Plattform unterstützt unter anderem:
- Datenprofiling und Erkennung sensibler Informationen
- statische, dynamische und inkrementelle Datenmaskierung
- Erstellung synthetischer Testdaten
- referenziell korrektes Database Subsetting
- Datentransformation und Datenmigration
- Integration in automatisierte Entwicklungs- und CI/CD-Prozesse
Unternehmen können damit Testdatenprozesse zentral gestalten und wiederkehrende Aufgaben automatisieren. Die IRI Workbench stellt dafür eine Eclipse-basierte Entwicklungsumgebung bereit, in der Datenregeln erstellt, verwaltet und über verschiedene Systeme hinweg eingesetzt werden können.
Datenschutz und Softwarequalität gemeinsam verbessern!
Sichere Testdaten sind ein wesentlicher Bestandteil moderner Softwareentwicklung. Sie ermöglichen realistische Tests, ohne sensible Produktivdaten unnötigen Risiken auszusetzen. Datenmaskierung, synthetische Datengenerierung und Database Subsetting schaffen gemeinsam eine belastbare Grundlage für Datenschutz, Testautomatisierung und zuverlässige Softwarequalität.
IRI Voracity führt diese Verfahren in einer integrierten Plattform zusammen. So entstehen wiederholbare und skalierbare Testdatenprozesse, die sich in bestehende Entwicklungsumgebungen einbinden lassen und Unternehmen bei der sicheren Nutzung ihrer Daten unterstützen.
Online-Schulung zum Testdatenmanagement: Wie sichere und realistische Testdaten in der Praxis geplant, erzeugt und automatisiert bereitgestellt werden, zeigt die Online-Schulung Testdatenmanagement – Testdaten sicher und zielgerichtet bereitstellen. Die Teilnehmenden lernen, synthetische Testdaten, Datenmaskierung und Database Subsetting passend zum jeweiligen Testziel einzusetzen. Praxisdemonstrationen mit IRI Voracity, RowGen, FieldShield und DarkShield veranschaulichen die technische Umsetzung in Entwicklungs-, Test-, DevOps- und CI/CD-Prozessen. Der nächste Termin findet am 12. und 13. Januar 2027 statt.
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.